Kod yazan yapay zeka araçlarını karşılaştırırken hep aynı soruyu soruyoruz: hangi model daha iyi? Eylül ayının ilk yarısında yayımlanan üç bağımsız çalışma, yanlış soruyu sorduğumuzu gösteriyor. Asıl fark modelde değil, modeli çalıştıran harness’ta. Bu fark ortalamada iki kat, uç örnekte beş kat.
Üçü de 10 gün içinde çıktı: UC Berkeley ve Arena’nın HarnessTax çalışması (16 Eylül), 43 sayfalık bir arXiv makalesi (17 Eylül) ve dokuz harness’ı bir dizüstü bilgisayarda yerel modelle karşılaştıran bağımsız bir ölçüm (10 Eylül). Sonuçlar birbirini destekliyor.
Harness Nedir?
Bir kod ajanı iki parçadan oluşur. Birincisi model: Claude Fable 5, GPT-5.6 Sol, Kimi K3. İkincisi harness: modelin hangi araçlara erişeceğini, bağlamı nasıl yöneteceğini, döngünün nasıl işleyeceğini yöneten yazılım katmanı. Claude Code bir harness’tır. Codex CLI bir harness’tır. Cursor, Cline, opencode, goose da öyle.
Bir kod ajanı seçerken aslında iki şey birden seçiyorsunuz, ama konuşurken hep tek bir şeyden bahsediyoruz. “Claude Code kullanıyorum” cümlesi hem bir modeli hem bir harness’ı kapsıyor ve ikisinin katkısı asla ayrı ayrı ölçülmüyordu. Berkeley ekibinin yaptığı tam olarak buydu.
Berkeley Ölçümü: 21 Model-Harness Çifti
Melissa Z. Pan liderliğindeki ekip (Ion Stoica ve Matei Zaharia da yazarlar arasında) yedi modeli üç harness ile eşleştirdi: Claude Code, Codex CLI ve Pi. Pi, sadece dört aracı olan açık kaynak minimal bir harness: read, write, edit, bash.
Testler SWE-bench Lite ve Terminal-Bench 2.0 üzerinde, 30 rastgele seçilmiş görev ve her nokta için 3 tekrar ile yapıldı. Toplam 21 kombinasyon.
| Claude Fable 5 ile | Claude Code | Codex CLI | Pi |
|---|---|---|---|
| Başarı oranı | %97,8 | %96,7 | %96,7 |
| Deneme başı maliyet | 1,33 $ | - | 0,67 $ |
| Ortalama tur sayısı | 15,3 | - | 15,4 |
| Araç sayısı | Çok | 10 | 4 |
Tabloyu okumanın kısa yolu: %1,1 daha fazla başarı için iki kat para. Tur sayısı bile neredeyse aynı (15,3’e karşı 15,4), yani ajan aynı sayıda adım atıyor, sadece her adım daha pahalıya geliyor.
Bu tek bir modele özgü değil. Paylaşılan modellerin geometrik ortalamasında Claude Code, SWE-bench Lite’ta Pi’nin 2,0 katı ve Codex’in 1,6 katı maliyete çıkıyor. Terminal-Bench 2.0’da Pi’nin 1,5 katı. Buna karşılık harness’ın başarı oranına ortalama etkisi SWE-bench Lite’ta ±%2, Terminal-Bench’te ±%5 bandında kalıyor.
Ekibin bu duruma verdiği ad harness vergisi: varsayılan aracı sorgulamadan kabul ettiğinizde ödediğiniz, faturada ayrı bir kalem olarak görünmeyen fark.
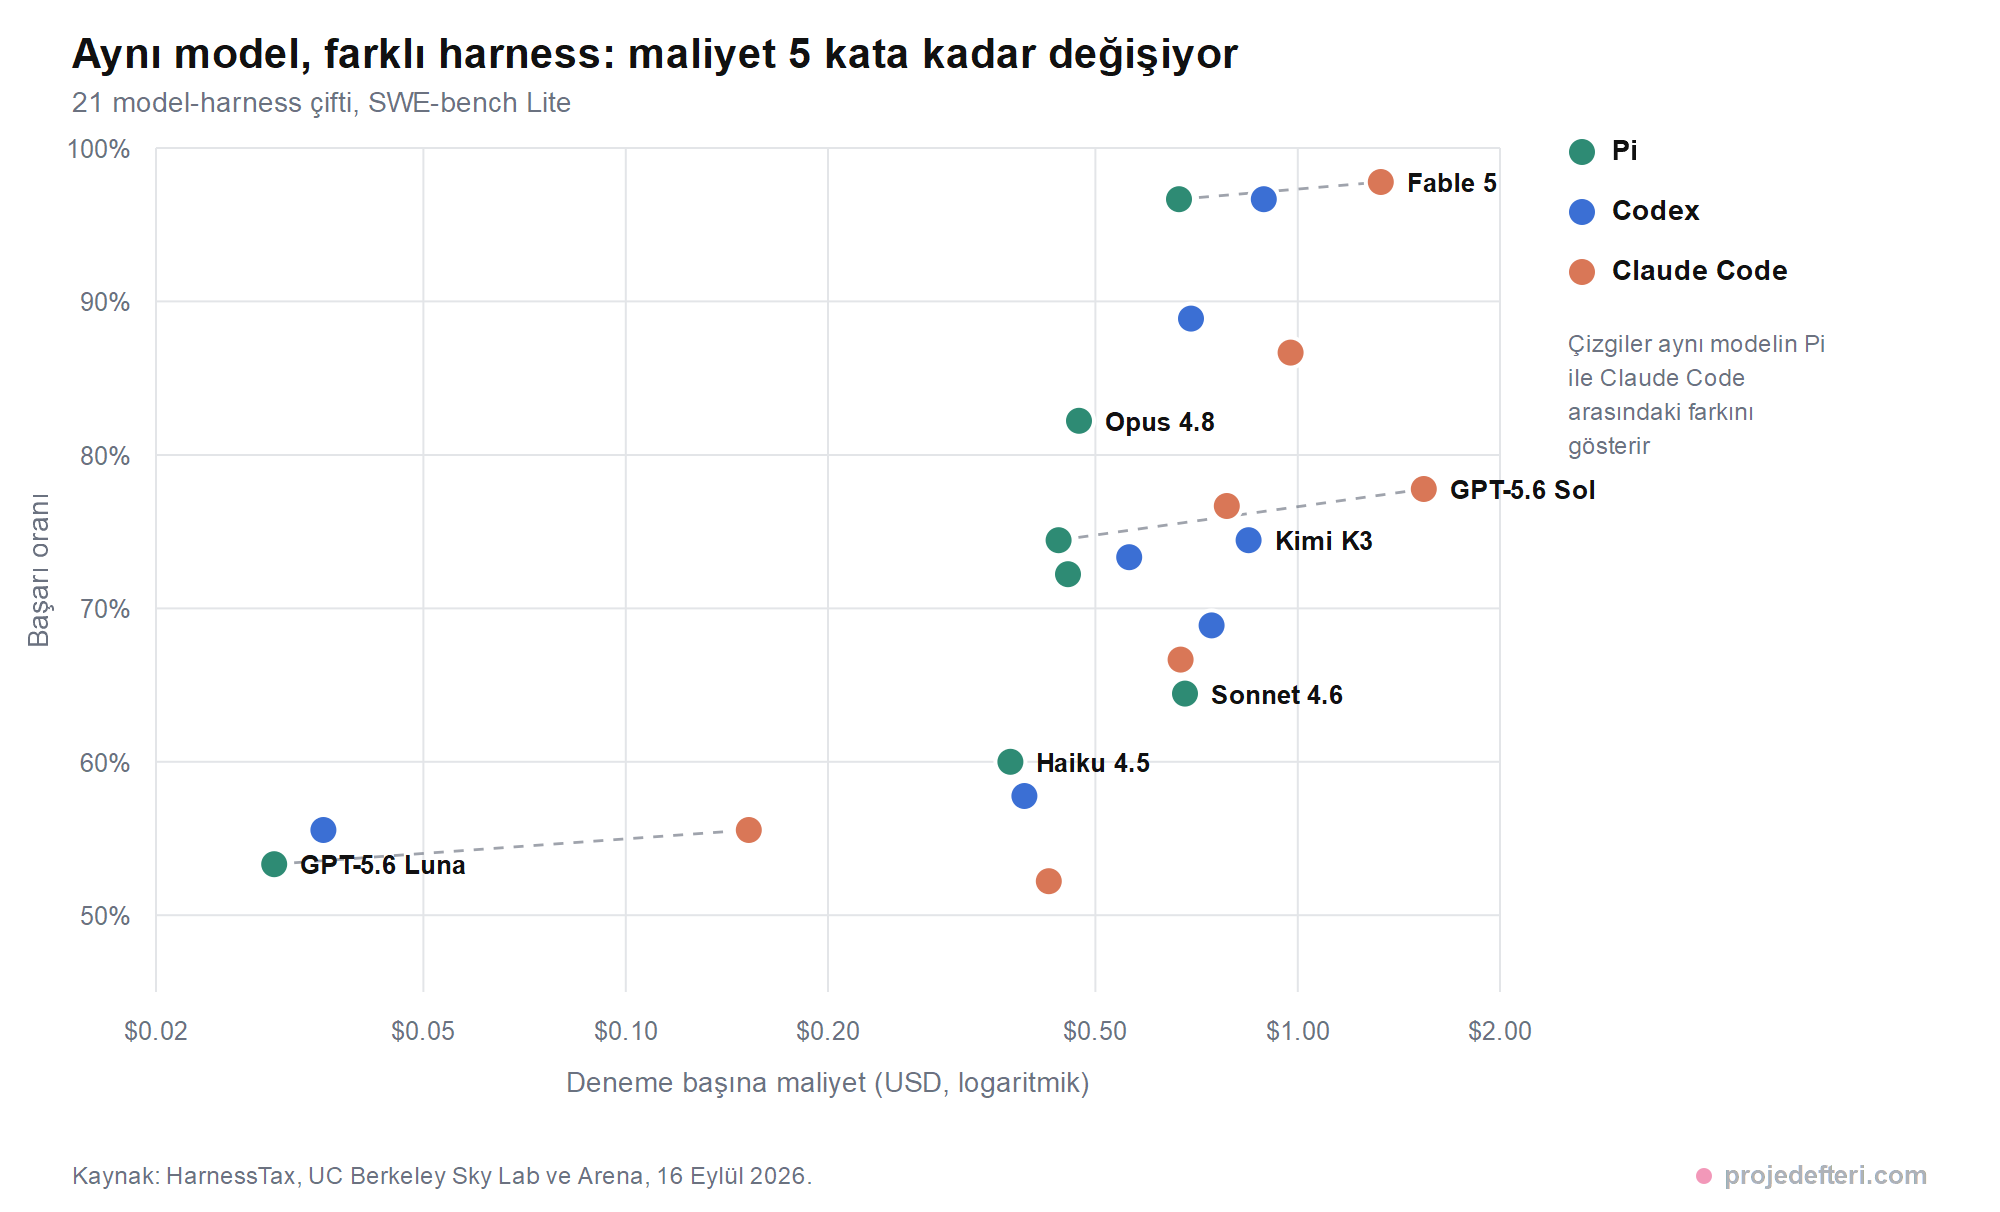
Grafikte dikkat edilecek yer noktaların yatay dağılımı. Aynı modelin üç noktası dikeyde neredeyse aynı hizada duruyor, yani başarı değişmiyor. Yatayda ise belirgin şekilde ayrılıyorlar. GPT-5.6 Luna’da fark en uçta: Pi’de 0,03 dolar, Claude Code’da 0,15 dolar. Beş kat.
Vergi İlk Çağrıda Başlıyor
Berkeley ekibi maliyet farkının nereden geldiğine de baktı. En çarpıcı bulgu ilk model çağrısında: Claude Code’un ortalama başlangıç bağlamı Pi’ninkinin 10 katından fazla. Daha uzun talimatlar, daha büyük araç şemaları.
Sağlayıcının bildirdiği ilk çağrı girdisi ortalamada Pi’de 1.972 token, Codex’te 11.308 token, Claude Code’da 27.011 token. Talimat metni tarafında fark daha da açılıyor: Pi 2.873 karakter, Codex 18.114 karakter, Claude Code 76.995 karakter. Araç sayısı da öyle: sırasıyla 4, ortalama 7,4 ve 23.
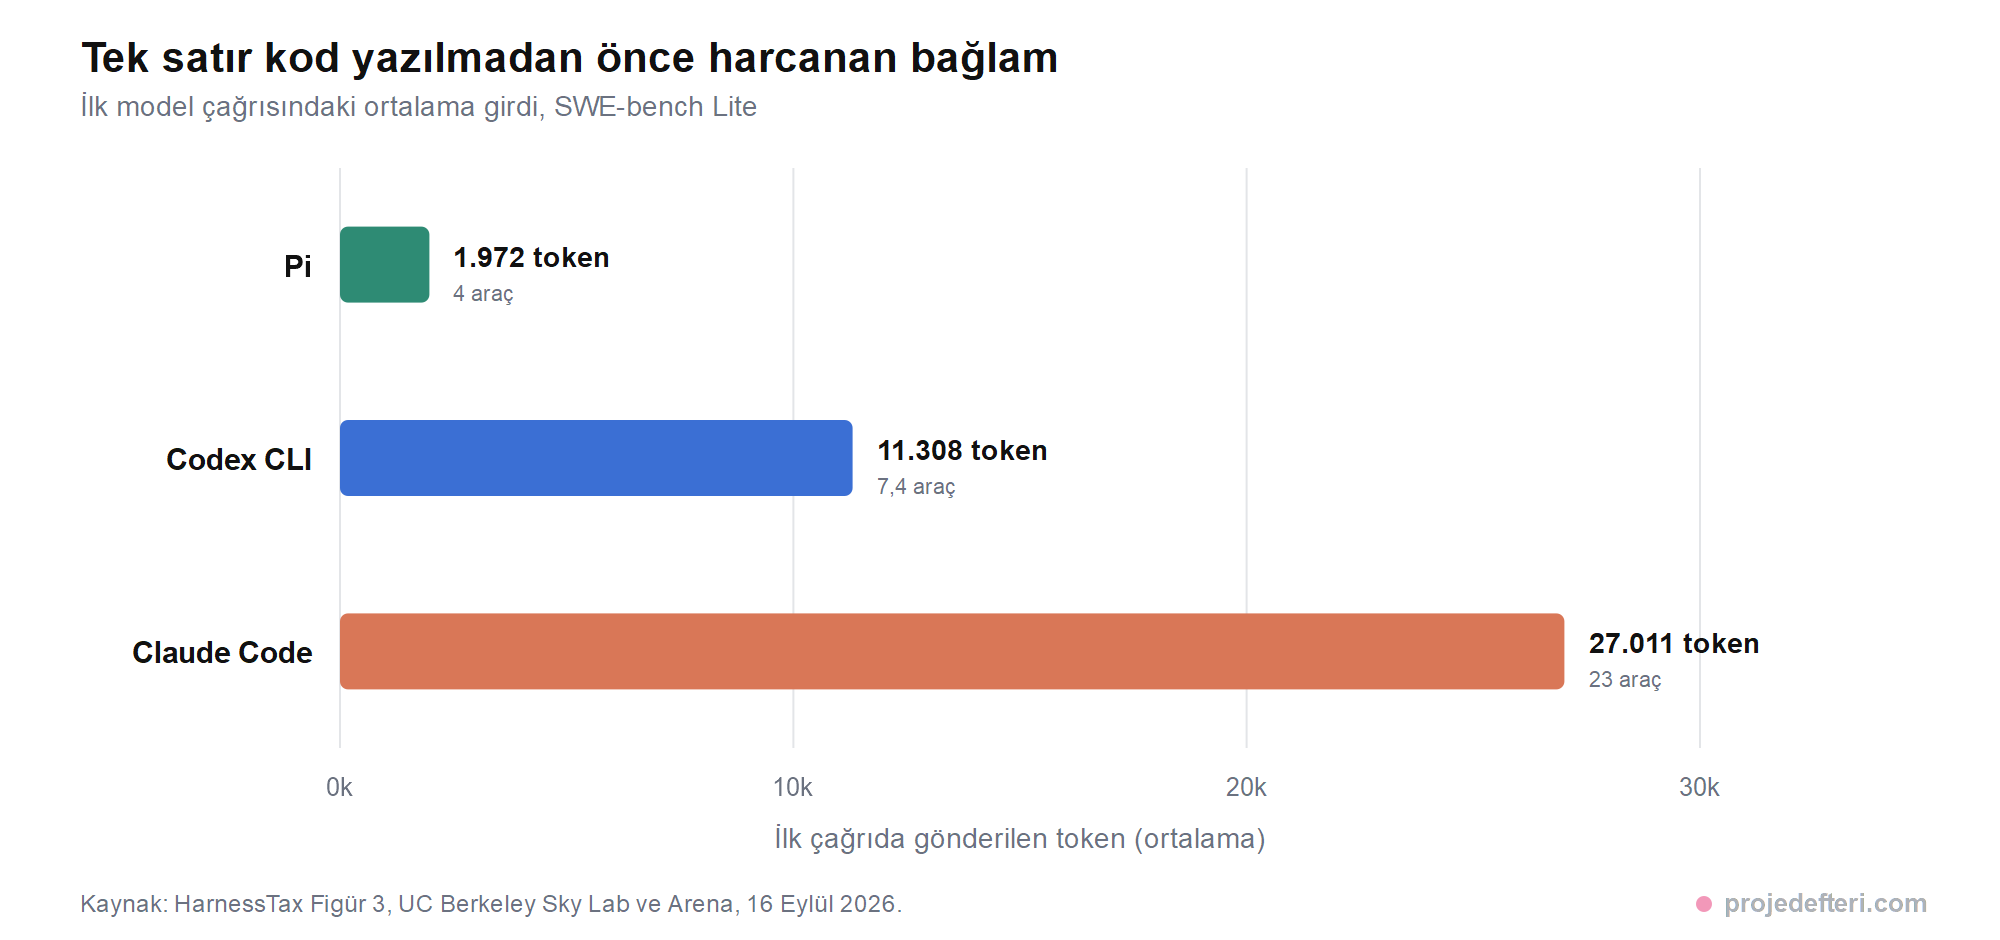
Bu, henüz hiçbir iş yapılmadan önce ödenen bir bedel. Ajan dosyayı okumadan, komutu çalıştırmadan, tek satır kod yazmadan önce model binlerce token’lık bir giriş metnini okumuş oluyor. Önbellekleme bu farkı kısmen yumuşatıyor, ama sıfırlamıyor.
Kendi kullanımınızda bu farkın ne ettiğini merak ediyorsanız LLM maliyet hesaplayıcısı ile aylık hacminizi girip bakabilirsiniz. İki kat, ayda 40 dolarlık bir kullanımda 20 dolar demek; on kişilik bir ekipte tablo değişiyor.
Sabit Ücretli Plandaysanız Fark Nereye Yansıyor?
Önemli bir ayrım: Berkeley ölçümü API token maliyetini ölçtü. Claude Code ve Codex CLI’ı aylık sabit ücretli bir abonelikle kullanıyorsanız faturanızda hiçbir şey değişmez, çünkü fatura zaten sabit.
Fark başka yere yansır: kullanım limitlerine iki kat hızlı çarparsınız. Aynı işi yapmak için iki kat token harcayan bir harness, aynı plan içinde yarı kadar iş yapmanıza izin verir. “Neden bu kadar erken limite takılıyorum?” sorusunun cevabı çoğu zaman modelde değil, harness’ın her çağrıda taşıdığı bagajda.
API anahtarıyla kullananlar içinse fark doğrudan paraya dönüşüyor ve aylık hacim büyüdükçe doğrusal büyüyor.
Model Kendi Harness’ının Dışında Daha İyi Olabiliyor
Berkeley çalışmasının en beklenmedik bulgusu bu. Sağlayıcılar modellerini kendi ortamları için optimize ettiklerini söylüyor. OpenAI, GPT-5-Codex’i Codex içinde ajan tabanlı yazılım mühendisliği için optimize edilmiş olarak tanımlıyor.
Ölçüm bunu doğrulamıyor. Altı Anthropic ve OpenAI modeli ile iki benchmark üzerinden yapılan 12 karşılaştırmanın 9’unda en yüksek başarıyı modelin kendi harness’ı değil, alternatif bir harness verdi.
| Karşılaştırma | Kendi harness'ı | Alternatif | Maliyet farkı |
|---|---|---|---|
| Sonnet 4.6, SWE-bench Lite | Claude Code %66,7 | Codex %68,9 | Benzer |
| GPT-5.6 Sol, Terminal-Bench 2.0 | Codex %78,9 | Pi %83,3 | 0,76 $ → 0,42 $ |
| Fable 5, SWE-bench Lite | Claude Code %97,8 | Pi %96,7 | 1,33 $ → 0,67 $ |
GPT-5.6 Sol satırı özellikle dikkat çekici: kendi harness’ının dışında hem daha başarılı hem yarı fiyatına çalışıyor.
Açık ağırlıklı taraf da geride değil. Kimi K3 , SWE-bench Lite’ta GPT-5.6 Sol’un yakınında, Pareto sınırına çok yakın duruyor. Yani “en iyi sonuç için kapalı model şart” varsayımı da bu ölçümde karşılık bulmuyor.
İkinci Çalışma: Hangi Bileşen Ne İşe Yarıyor?
Berkeley çalışması harness’ları bütün olarak karşılaştırdı. 17 Eylül’de yayımlanan arXiv:2609.20804 makalesi ise tersini yaptı: çalışma döngüsünü sabitleyip üç bileşeni tek tek değiştirdi.
Run-Ze Fan ve ekibi, dört model üzerinde SWE-Bench Verified ve Terminal-Bench 2.1 ile 176 eşleştirilmiş konfigürasyon denedi: beş bağlam yönetim stratejisi, dört farklı bağlam penceresi bütçesi, artı planlama ve araç uzayı ablasyonları. 43 sayfalık sonuç şunu söylüyor:
- Bağlam yönetimi, bağlam penceresi bütçesi daraldıkça değerleniyor. Faydanın büyük kısmı doğruluğu artırmaktan değil, bağlam taşması kaynaklı başarısızlıkları önlemekten geliyor.
- En verimli strateji, kural tabanlı budamayı LLM ile özetlemenin önüne koymak. Budanan içeriği geri çağrılabilir yapmak ise ekstra karmaşıklık getiriyor, modeller bu imkanı nadiren kullanıyor ve doğrulukta kazanç yok.
- Planlama, zayıf modellerde doğruluk desteği; güçlü modellerde ise doğruluğu pek değiştirmeden maliyet düşürücü bir rol oynuyor.
- Araç uzayı: bash’te zayıf modeller hazır tanımlı araçlardan fayda görüyor. Bash’i iyi kullanan modeller ise sadece bash arayüzüyle çalışıp özellikle komut satırı ağırlıklı görevlerde belirgin şekilde daha ucuza sonuç alıyor.
Son madde Berkeley bulgusuyla birebir örtüşüyor: Pi’nin dört aracı, güçlü modellerde 26 araçlı bir harness kadar iş görüyor ve daha az token yakıyor.
Yerel Modelde Vergi Katlanıyor
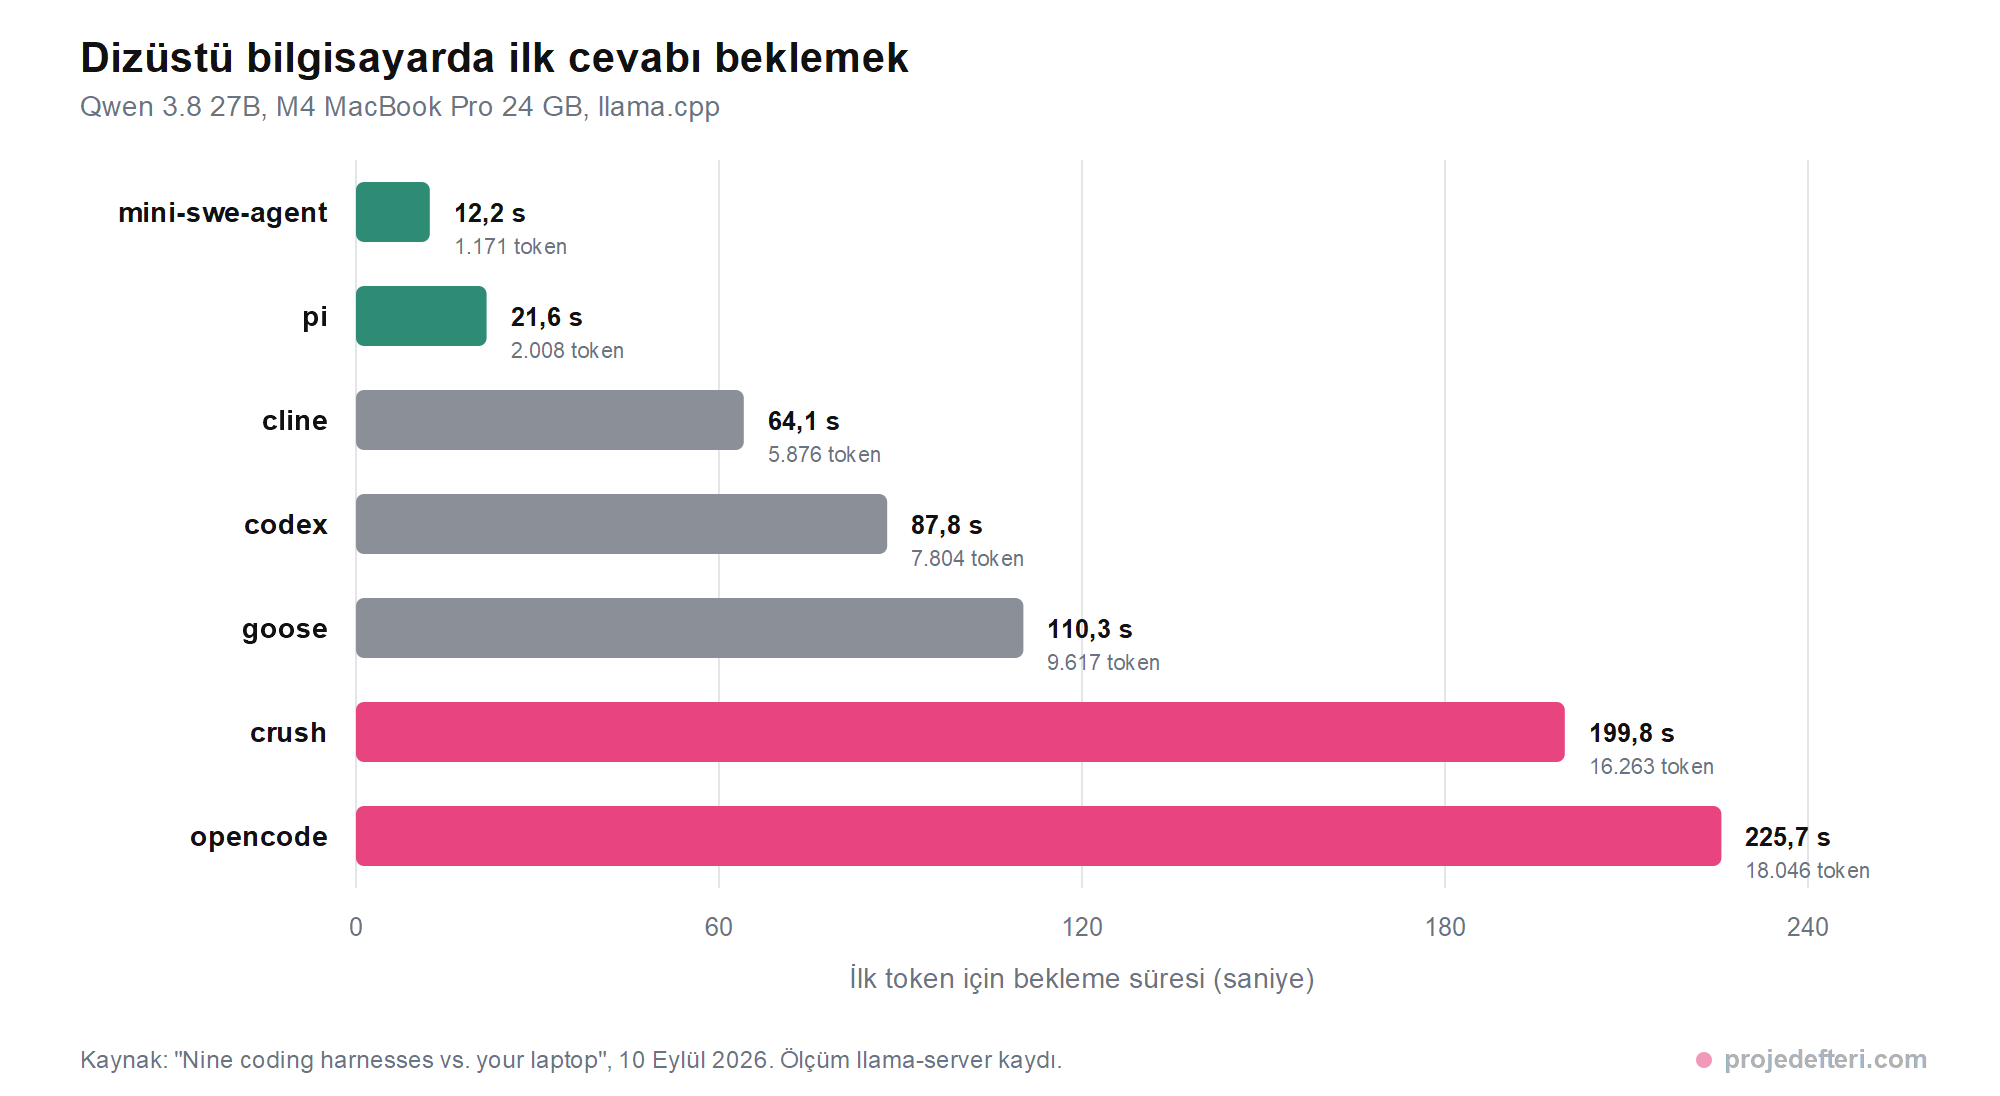
Üçüncü ölçüm işi bambaşka bir yere taşıyor. Dokuz harness, tek bir MacBook Pro’da (M4, 24 GB) llama.cpp üzerinden servis edilen 3 bit Qwen 3.8 27B ile, sekiz Exercism görevi üzerinde test edildi.
Burada matematik acımasız. Bir dizüstü bilgisayar yaklaşık 90 token/saniye okur, 10 token/saniye yazar. Yani sistem promptunun her 1.000 token’ı yaklaşık 11 saniye bekleme demek. Veri merkezinde 10.000+ token/saniye prefill hızıyla fark edilmeyen şey, localhost’ta doğrudan yüzünüze çarpıyor.
| Harness | 1. tur promptu | İlk token beklemesi | Araç sayısı | Geçen görev |
|---|---|---|---|---|
| mini-swe-agent | 1.171 token | 12,2 sn | 1 | 11/24 |
| pi | 2.008 token | 21,6 sn | 4 | 19/24 |
| cline | 5.876 token | 64,1 sn | 26 | 17/24 |
| codex | 7.804 token | 87,8 sn | 10 | 19/24 |
| goose | 9.617 token | 110,3 sn | 18 | 22/24 |
| crush | 16.263 token | 199,8 sn | 26 | 18/24 |
| opencode | 18.046 token | 225,7 sn | 10 | 15/24 |
Aradaki uçurum şu: opencode ile pi arasında ilk cevabı görmek için 204 saniye fark var. Üstelik bu fark her oturumun başında tekrarlanıyor.
Bağlam tarafı da aynı hikaye. İyi bir dizüstü bilgisayarda makul bir modelle çalışırken iş için elinizde yaklaşık 32.000 token kalıyor. Pi bu bütçenin %94’ünü size bırakıyor. Opencode 18.046 token’ı daha kapıdan girerken harcadığı için elinizde %44 kalıyor.
Üçüncü bir sorun daha var: yan istekler. Oturum başlığı üretmek, özet çıkarmak gibi işler için harness arka planda ek çağrılar atıyor. 24 görev boyunca opencode 33, crush 51, dsh 24 yan istek yaptı ve neredeyse hepsi bir ajan turuyla çakıştı. Sonuç: model, duvar saati süresinin opencode’da %125’i, crush’ta %114’ü boyunca meşgul göründü. Yani tek GPU’da aynı anda iki istek.
chad adlı harness’ı geliştiriyor ve bunu yazının başında açıkça belirtiyor. chad satırlarını (24/24 geçiş) bu yüzden bir sıralama olarak değil, yöntemin uç örneği olarak okumak gerekiyor. Diğer harness’ların sayıları llama-server’ın kendi kayıtlarından geliyor, harness’ların kendi beyanından değil.Cursor ve Cline Neden Testte Yok?
Berkeley ölçümü üç harness ile sınırlı: Claude Code, Codex CLI ve Pi. Türkiye’de de yaygın kullanılan Cursor, Windsurf ya da Cline bu karşılaştırmada yer almıyor. Cline sadece dizüstü bilgisayar testinde görünüyor: 26 araç, 5.876 token’lık ilk tur promptu, 64,1 saniye ilk token beklemesi.
Yine de bu, diğer araçlar hakkında hiçbir şey bilinmediği anlamına gelmiyor. Çünkü ölçülen mekanizma araçtan bağımsız ve herkes için aynı: ilk çağrıdaki bağlam boyutu, araç şeması sayısı, yan istek trafiği ve önbellek isabet oranı. Bu dört sayıyı kendi aracınız için çıkarabilirseniz, onu bu skalada bir yere yerleştirebilirsiniz.
Editör içine gömülü araçlarda (Cursor, Windsurf gibi) bir katman daha var: dosya indeksleme, otomatik tamamlama modeli ve düzenleyici bağlamı da token harcıyor. Bu araçlar zaten kendi abonelik modelleriyle geldiği için harness vergisi doğrudan faturaya değil, yine kullanım limitine yansıyor.
Büyük Sistem Promptları Neden Var?
Bu tablolara bakıp “opencode kötü yazılmış” sonucuna varmak yanlış olur. Ölçümü yapan kişi de aynı uyarıyı yapıyor: 18.000 token’lık bir sistem promptu, API arkasındaki güçlü bir modele gerçekten yardım ettiği için orada. 26 araç şeması, 200.000 token’lık bağlamınız ve anında prefill’iniz varken sorun değil.
Bu tasarım kararlarının hepsi, prefill’in pratikte bedava olduğu bir ortamda alındı. Veri merkezinde 18.046 token’ı okumak 1,8 saniye sürüyor. Aynı iş dizüstü bilgisayarda 226 saniye. Aynı kod, aynı prompt, 125 kat fark.
Yani sorun harness’ların kötü olması değil, varsayımlarının artık her ortamda geçerli olmaması. Veri merkezi için optimize edilmiş bir araç, yerel modelde kullanılmaz hale geliyor; API’de ise fark kendini sessizce faturada gösteriyor.
Kendi Harness Verginizi Nasıl Ölçersiniz?
Bu ölçümleri kendi projenizde tekrarlamak için akademik altyapıya ihtiyacınız yok. Üç adım yeterli:
- İlk çağrının boyutunu ölçün. Çoğu harness bir hata ayıklama veya ayrıntılı çıktı modu sunuyor; buradan sistem promptu ve araç şemalarının toplam token sayısını görebilirsiniz. Ham metni token sayacına yapıştırmak da işi görür. 2.000 ile 18.000 arasında bir yerdesiniz.
- Aynı görevi iki harness’ta çalıştırın. Gerçek bir görev seçin, aynı istemi kelimesi kelimesine verin ve toplam token kullanımını karşılaştırın. Tek görev yeterli değil, en az üç tekrar yapın: Berkeley ekibi de her nokta için üç tekrar kullandı.
- Turu değil parayı karşılaştırın. Fable 5 örneğinde tur sayısı 15,3’e 15,4 ile neredeyse aynıydı, fark tamamen tur başına harcanan token’da. “Daha az adımda bitirdi” hissi maliyeti anlatmıyor.
Bu üç adım tek bir öğleden sonrada tamamlanır ve sonucu doğrudan sizin iş yükünüzü yansıtır. Benchmark’lardan daha değerli olan da bu: ölçüm sizin kod tabanınızda yapılıyor.
Peki Ne Yapmalı?
Üç çalışmadan çıkan pratik sonuçlar:
- Varsayılanı sorgulayın. Aynı aboneliği, aynı modeli kullanmaya devam edip sadece harness değiştirerek maliyeti yarıya indirebilirsiniz. Berkeley ölçümünde başarı farkı ölçüm gürültüsü seviyesinde kaldı.
- Model ve harness’ı ayrı seçin. “Claude modeli kullanıyorsam Claude Code kullanmalıyım” varsayımı 12 karşılaştırmanın 9’unda yanlış çıktı.
- Yerel model çalıştırıyorsanız harness seçimi kritik. Ollama, Kimi ve GLM’i Claude Code’a bağlama yazısındaki kurulumu yaptıysanız, sistem promptu küçük bir harness’a geçmek tek başına en büyük hız kazancınız olabilir.
- Araç sayısına bakın. 26 araçlı bir harness, güçlü bir modelde 4 araçlı bir harness’tan daha iyi sonuç vermiyor, ama her çağrıda o şemaların bedelini ödüyorsunuz.
- Aylık faturanızı hesaplayın. Kaç token yaktığınızı token sayacı ile, ne ödediğinizi maliyet hesaplayıcısı ile ölçün. İki kat fark soyut bir sayı değil.
Çekinceler
Berkeley ekibi kendi sınırlarını açıkça yazıyor: ölçüm iki açık kaynak benchmark üzerinde yapıldı ve modellerin eğitim sırasında bu görevleri görmüş olma ihtimali var. Başka iş yüklerinde sonuçlar farklı çıkabilir.
Ayrıca benchmark görevleri, gerçek bir geliştirme oturumunun tamamını temsil etmiyor. Oturumlar arası hafıza, geri bildirim döngüleri, uzun süreli görevler bu testlerin kapsamı dışında. Zengin harness özellikleri tam olarak bu noktalarda karşılığını veriyor olabilir.
Bir de şu var: bu üç çalışma “basit harness her zaman kazanır” demiyor. Söyledikleri daha ince. Harness karmaşıklığı ampirik bir denge meselesi; modelin gücüne, iş yüküne ve bağlam bütçesine göre değişiyor. Model güçlendikçe iskeleye daha az ihtiyaç duyuluyor, sınırdaki zor problemlerde ise yapılandırılmış rehberlik hâlâ işe yarıyor.
Ama günlük iş için mesaj net: Claude Code’u nasıl kullandığınız kadar, hangi harness’ta çalıştığınız da faturanızı belirliyor. Ve şu ana kadar kimse bunu size söylemiyordu.