- Grok 4.7, SpaceXAI’ın 21 Eylül 2026‘da duyurduğu yeni amiral gemisi modeli. Beklenenden on gün geç geldi.
- Fiyat yine sabit: 1 milyon token için 2 dolar girdi, 6 dolar çıktı. Üst üste üçüncü sürümde aynı etiket.
- 500 bin token bağlam, dört düşünme kademesi (low, medium, high, xhigh), Mayıs 2026 bilgi kesimi.
- Kodlamada rakiplerini geçemiyor ama elektrik mühendisliği ve hukuk testlerinde tabloyu önde kapatıyor.
Musk eylül başında “on gün” demişti, tarih iki kez kaydı. Model 21 Eylül 2026‘da çıktı ve artık tahmin değil, SpaceXAI’ın kendi fiyat listesi ve benchmark tablosu var.
Grok 4.7 Nedir?
Kodlama, ajan görevleri ve bilgi işleri için konumlandırılmış yeni amiral gemisi. Künyesi:
| Özellik | Değer |
|---|---|
| Model kimliği | grok-4.7 |
| Bağlam penceresi | 500.000 token (yaklaşık 375 bin kelime) |
| Girdi / çıktı | Metin + görsel / yalnızca metin |
| Bilgi kesim tarihi | Mayıs 2026 |
| Düşünme kademeleri | low, medium, high (varsayılan), xhigh |
| Batch API | Desteklenmiyor |
| Hız limiti | Saniyede 150 istek, dakikada 50 milyon token |
Parametre sayısı açıklanmadı. Şirketin verdiği tek teknik bilgi, Grok 4.6’ya kıyasla daha büyük bir taban model kullanıldığı.
Bu sürümde değişen dört şey var: daha büyük taban model, saatler süren görevlere ağırlık veren daha uzun bir pekiştirmeli öğrenme koşusu, adımlar arasında kendi işini daha sık doğrulama ve şirketin kendi ajan çerçevesini (Grok Bot) doğuştan tanıma.
Benchmark: Rakiplerine Karşı Nasıl? 📊
SpaceXAI’ın duyurusundaki tablo. Grok 4.7 skorları xhigh, Grok 4.6 skorları high kademesinde:
| Test | Grok 4.7 xHigh | Grok 4.6 High | GPT-5.6 Sol Max | Fable 5.1 Max |
|---|---|---|---|---|
| Girdi / çıktı fiyatı (1M) | $2 / $6 | $2 / $6 | $4 / $20 | $10 / $50 |
| CursorBench 4.0 | 46,3% | 40,4% | 41,7% | 51,8% |
| DeepSWE v1.1 | 71,0%* | 65,2% | 72,7% | 70,0% |
| EEBench (elektrik müh.) | 64,0% | 53,0% | 39,4% | 56,4% |
| Terminal-Bench 4.0 | 38,0% | 20,3% | 37,3% | 57,9% |
| Harvey Hukuk Ajanı | 19,6% | 15,8% | 2,5% | 6,7% |
| HealthBench Professional | 56,7% | 48,5% | 60,5% | 62,1% |
| GDPval (Elo) | 1695 | 1605 | 1542** | 1735 |
* high kademesinde alındı. ** GDPval satırındaki skor GPT-6 Astra (max) modeline ait.
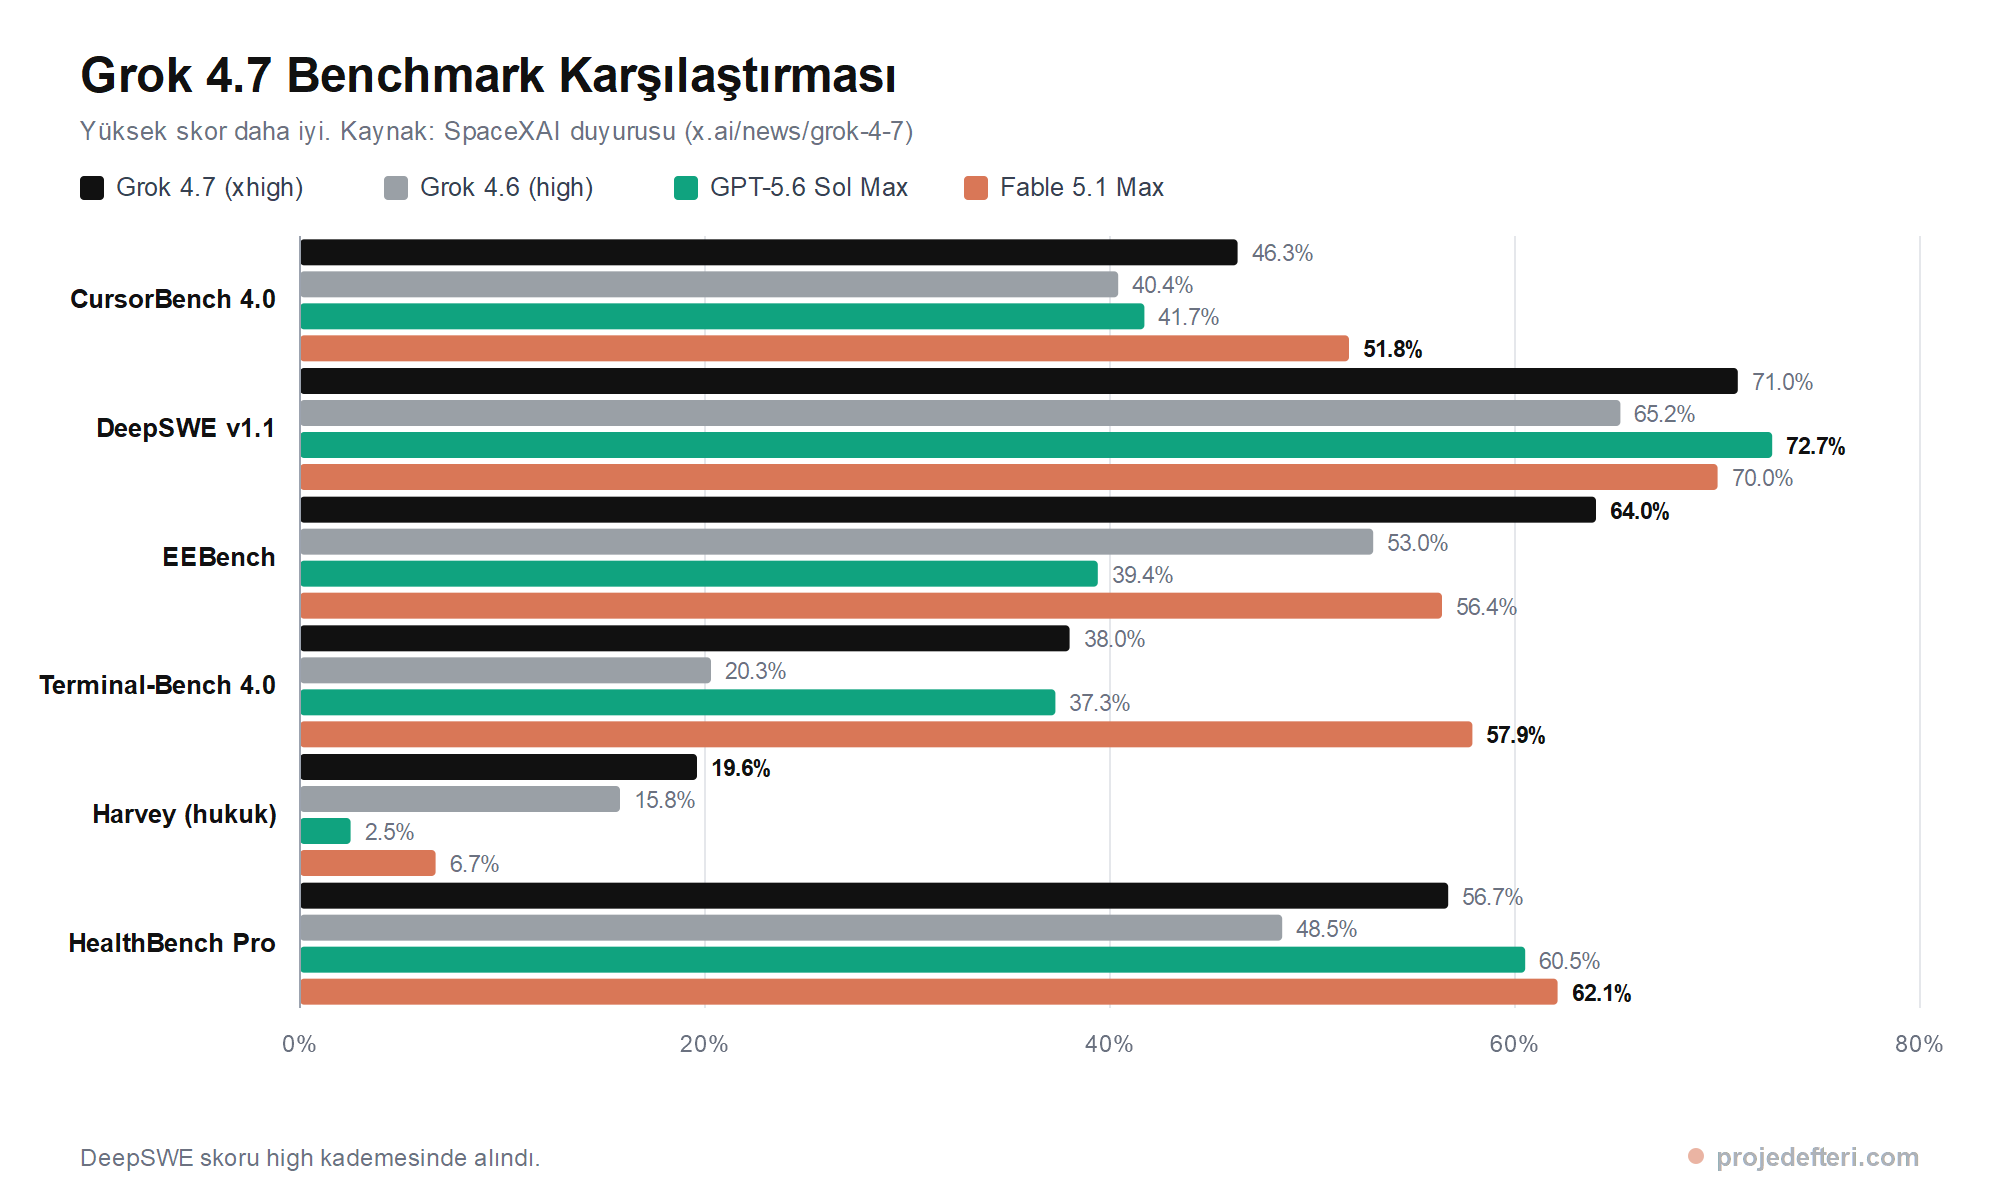
Grok 4.7 her testte kendi önceki sürümünü geçiyor, rakiplere karşı ise ikiye bölünüyor. Kazandığı yer alan uzmanlığı: EEBench’te ikinciyi 7,6 puan geride bırakıyor, Harvey hukuk testinde tablodaki en yüksek skoru alıyor. Kaybettiği yer saf yazılım mühendisliği: Terminal-Bench 4.0’da Fable 5.1 tam 20 puan önde.
Fiyat ve 200 Bin Token Tuzağı 💸
1 milyon token başına:
| Kalem | 200K altı istek | 200K üstü istek |
|---|---|---|
| Girdi | $2,00 | $4,00 |
| Önbellekten girdi | $0,50 | $1,00 |
| Çıktı | $6,00 | $12,00 |
Tarife Grok 4.6 ile birebir aynı. Aynı duyuruda GPT-5.6 Sol 4/20, Fable 5.1 10/50 dolar; yani Grok 4.7’nin çıktı tokenı Fable 5.1’in sekizde biri fiyatında.
Tuzak şu: istek 200 bin tokenı aştığı anda tarife ikiye katlanıyor ve yüksek fiyat isteğin tamamına uygulanıyor. 199 bin tokenlık istem 2 dolardan, 201 binlik istem tamamı 4 dolardan işlenir. Ayrıca ABD bölgesel uç noktası global tarifenin 1,1 katı ve Batch indirimi yok.
Günde 5 milyon girdi, 1 milyon çıktı tokenı harcayan bir ajan hattının aylık faturası:
| Model | Aylık (30 gün) |
|---|---|
| Grok 4.7 | $480 |
| GPT-5.6 Sol | $1.200 |
| Fable 5.1 | $3.000 |
Ucuz token her zaman ucuz iş demek değil: aynı görevi daha çok adımda bitiren model farkı kapatabilir. Kendi hacminizi LLM maliyet hesaplayıcımıza girip karşılaştırın.
Kimin İçin Mantıklı?
- Donanım, devre, mühendislik hesabı: EEBench farkı büyük (64,0’a karşı GPT-5.6 Sol’un 39,4’ü), tablodaki en iyi seçenek.
- Sözleşme ve hukuk metinleri: Harvey testindeki 19,6 yine tablonun en yükseği.
- Yüksek hacimli, maliyete duyarlı işler: sınıflandırma ve özetlemede
lowkademesiyle fatura ciddi düşüyor. - Terminal ve depo çapında kodlama ajanları: tablo hâlâ Claude Fable 5.1‘i gösteriyor.
Güvenlik tarafında şirket baştan yazılmış bir koruma yığını kullandığını söylüyor: LatchBio biyogüvenlik testinde %62,4 ile birinci, HackerBench v0.3’te riskli istemlerin yalnızca %3,3’ü modelden geçebiliyor.
Çıkmadan Önce Konuşulanlar Ne Oldu?
Haftalarca “2,1 trilyon parametre” ve “SpaceX roket verisiyle eğitildi” başlıkları dolaştı. Resmi duyuruda hiçbiri yok:
| İddia | Duyurudaki karşılığı |
|---|---|
| 2,1 trilyon parametre | Rakam yok, sadece “daha büyük taban model” |
| SpaceX roket ve uydu verisi | Geçmiyor |
| Tüm modelleri geçecek | Yedi testin üçünde birinci |
| 12 Eylül’de çıkacak | 21 Eylül’de çıktı |
Kaynağı x.ai/news ya da docs.x.ai değilse rakamı ciddiye almayın. Bekleyiş dönemini ayrı bir yazıda takip etmiştik.
Nereden Kullanılır?
Cursor’da model listesinde, Grok Build üzerinde (ücretsiz denenebiliyor), SpaceXAI API’sinde grok-4.7 kimliğiyle ve üçüncü parti araçlar ile model yönlendiricilerinde. İki kat hızlı bir varyantı var, fiyatı da iki katı. Açık ağırlık yok.
API, OpenAI kütüphanesiyle uyumlu:
from openai import OpenAI

client = OpenAI(api_key="ANAHTARINIZ", base_url="https://api.x.ai/v1")

cevap = client.chat.completions.create(
    model="grok-4.7",
    reasoning_effort="high",   # low | medium | high | xhigh
    messages=[{"role": "user", "content": "Grok 4.7'yi tek cümleyle anlat."}],
)
print(cevap.choices[0].message.content)
Basit işlerde low kademesi ciddi tasarruf sağlar; model düşünürken ürettiği tokenlar da çıktı olarak faturalanır. Responses API’de reasoning.encrypted_content alanı istenmese bile her zaman döner.
Sıkça Sorulan Sorular
Soru: Grok 4.7 çıktı mı? Cevap: Evet, 21 Eylül 2026‘da duyuruldu ve aynı gün API, Cursor ve Grok Build üzerinden kullanıma açıldı.
Soru: Grok 4.7 fiyatı ne kadar? Cevap: 1 milyon token için 2 dolar girdi, 0,50 dolar önbellekli girdi, 6 dolar çıktı. 200 bin tokenı aşan isteklerde tarife ikiye katlanıyor.
Soru: Grok 4.7 kaç parametre? Cevap: Açıklanmadı. “2,1 trilyon” iddiasının resmi bir kaynağı yok.
Soru: Grok 4.7, Claude ve GPT’den iyi mi? Cevap: Elektrik mühendisliği ve hukuk testlerinde birinci, kodlama testlerinde Claude Fable 5.1 açık ara önde. Fiyat/performansta Grok önde.
Soru: Grok 4.7 ücretsiz mi? Cevap: API ücretli. Grok Build üzerinden ücretsiz deneme, grok.com ve Grok uygulamasında sınırlı ücretsiz kullanım var.
Sağlıcakla kalın… 🙂