15 Eylül 2026‘da iki yıllık sessizlikten çıkan TypeSafe AI, yapay zeka dünyasına alıştığımızdan farklı bir şey sundu: metin üretmeyen bir model. Adı Jev. Bir soru sorduğunuzda cevap yazmıyor, onun yerine yazılımınızın doğrudan kullanabileceği tipli bir karar ve o kararın olasılığını döndürüyor.
Şirketin kurucusu Diogo Almeida. OpenAI’da RLHF ve ChatGPT’nin arkasındaki araştırmada çalışmış bir isim. Yani sohbet modellerini bugünkü haline getiren ekibin içinden biri, şimdi tam tersi yönde bir model sınıfı üretmiş durumda. Duyuruyu kendi hesabından yaptı ve gönderi 36 milyonun üzerinde görüntülenme aldı:
Diogo Almeida: Jev duyurusu (15 Eylül 2026)
Açılış sorusu şirketin bütün tezini özetliyor: sohbette insanüstü modeller neden bizi otomasyona götürmedi?
Jev Nedir?
Jev, TypeSafe’in System One Model adını verdiği yeni bir model sınıfının ilk halka açık üyesi. İsim, Daniel Kahneman’ın Hızlı ve Yavaş Düşünme kitabındaki hızlı, sezgisel “Sistem 1” düşünceye gönderme yapıyor. Modelin kendi adı ise ekonomist William Stanley Jevons’tan geliyor: kömürde verimlilik arttıkça tüketimin azalmayıp arttığını gösteren Jevons paradoksu.
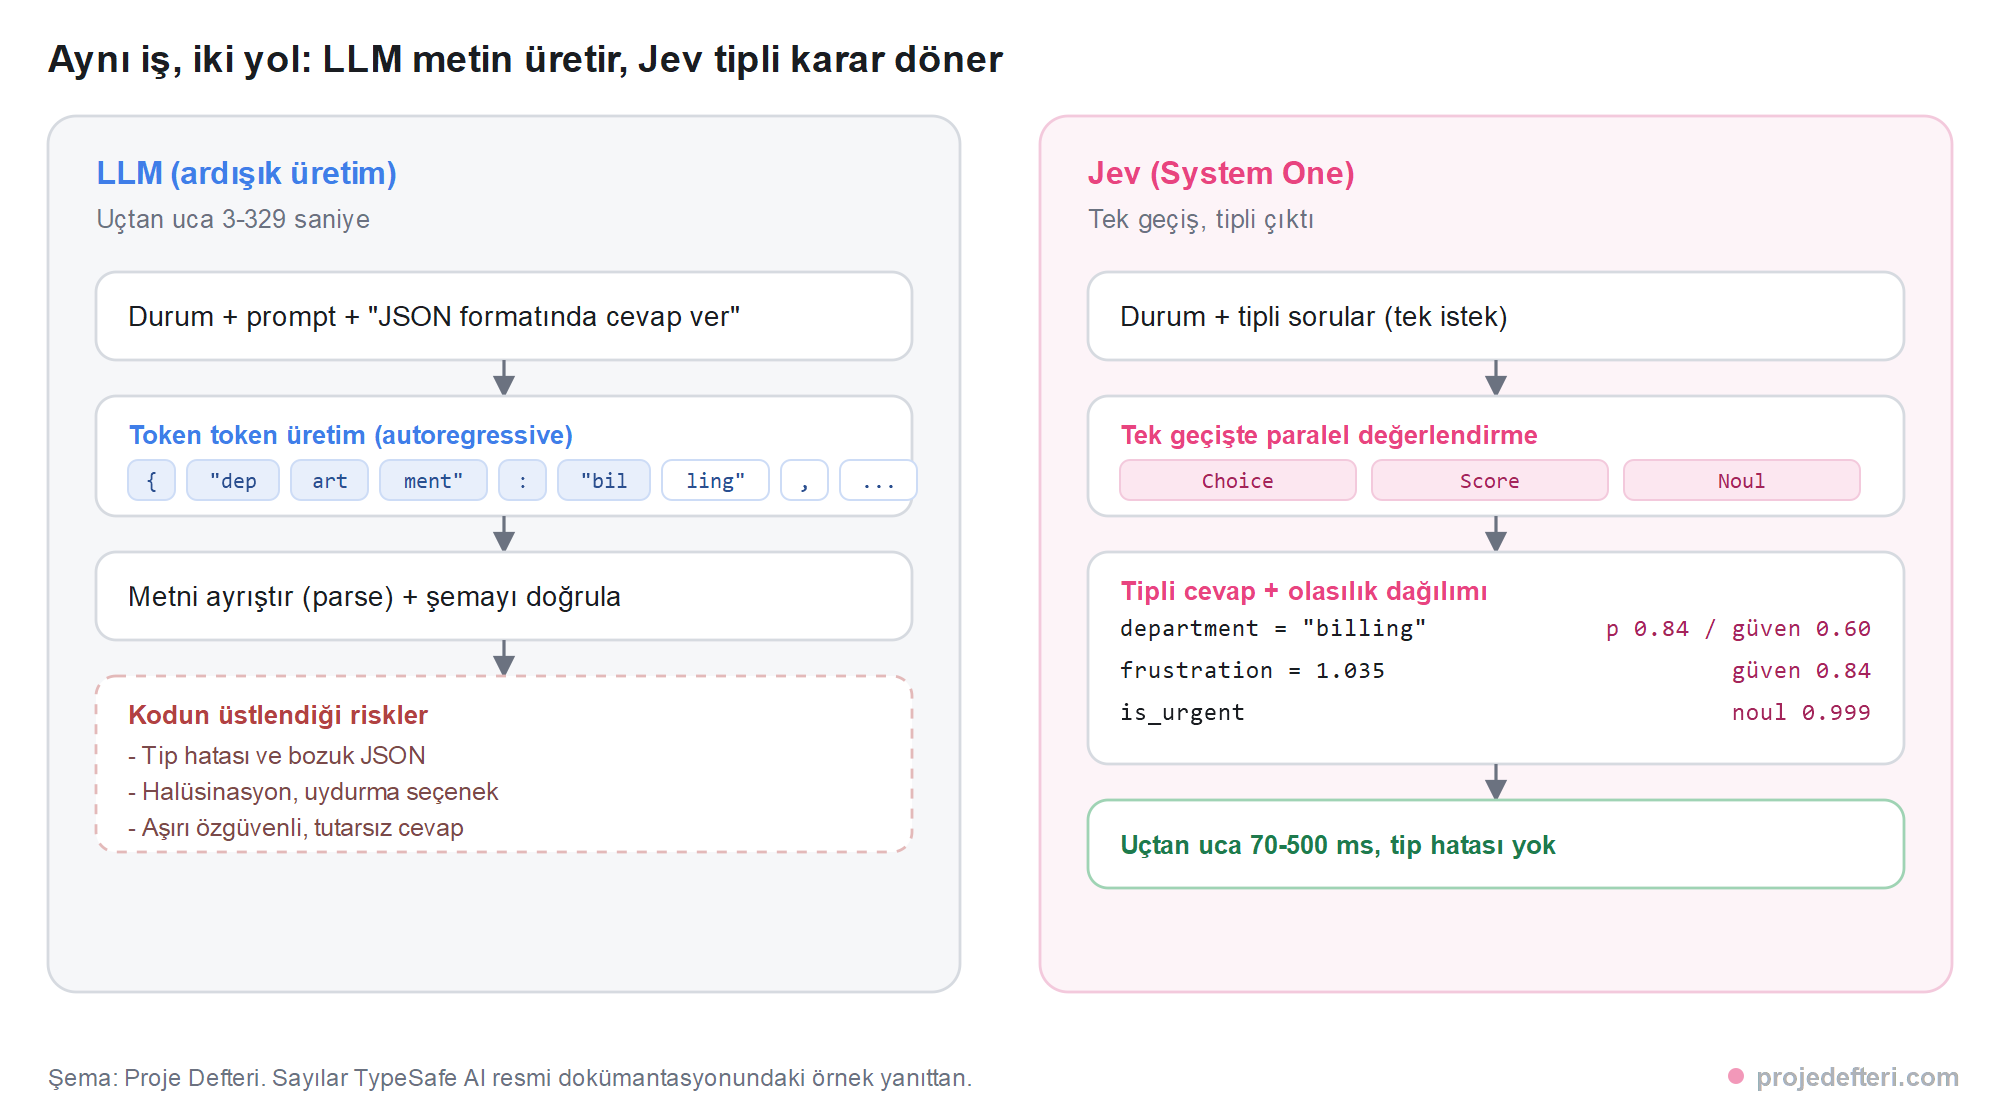
Çalışma mantığı şu: modele bir durum (state) ve o durumla ilgili tipli sorular gönderiyorsunuz. Jev her soruyu tek geçişte, paralel ve birbirinden bağımsız değerlendirip tipli cevabı olasılık dağılımıyla birlikte döndürüyor. Ortada üretilecek bir metin olmadığı için ayrıştırma (parse) yok, şema doğrulaması yok, uydurma bir alan adı ya da bozuk JSON riski yok.
TypeSafe bunu şöyle özetliyor: Jev’i frontier seviyesinde zeka barındıran bir fonksiyon çağrısı gibi düşünün. İçeri yapılandırılmamış durum girer, dışarı tipli olasılıklı kararlar çıkar.
RLCD: Yeni Eğitim Yöntemi
LLM’ler RLHF (insan geri bildiriminden pekiştirmeli öğrenme) ya da RLVR (doğrulanabilir ödüllerle pekiştirmeli öğrenme) ile eğitiliyor. İkisinin de hedefi insanın beğeneceği ya da programatik olarak doğrulanabilen çıktılar.
TypeSafe ise RLCD adını verdiği bir yöntem kullanıyor: Reinforcement Learning for Calibrated Decisions, yani kalibre edilmiş kararlar için pekiştirmeli öğrenme. Buradaki hedef farklı: modelin verdiği olasılıkların dürüst olması. Kalibrasyon şu demek: model bir şeye 0,9 olasılık verdiğinde gerçekten yaklaşık on seferin dokuzunda haklı olmalı.
Bu detay kulağa akademik geliyor ama otomasyonun tam kalbinde duruyor. Almeida’nın ifadesiyle, bir model bir işi %95 oranında doğru yapıyor ama kalan %5’te olduğunu size söylemiyorsa, o işi otomatikleştiremezsiniz.
Hız Nereden Geliyor?
Bir LLM’den yapılandırılmış çıktı istediğinizde model aslında iki iş birden yapıyor: hem kararı veriyor hem de o kararı JSON biçiminde harf harf yazıyor. Süslü parantez de, alan adları da, virgüller de tek tek üretilen tokenlar. Her token bir öncekine bağlı olduğu için bu iş sıraya giriyor ve donanım boşta bekliyor.
Jev’de yazılacak bir metin yok. Model durumu bir kez okuyor, tanımladığınız soruların hepsini aynı geçişte değerlendiriyor ve cevapları doğrudan olasılık olarak veriyor. Üretilecek karakter olmadığı için ardışıklık da ortadan kalkıyor. TypeSafe’in “yeni bir örnekleyici” dediği şey tam olarak burası: çıktıyı sıraya sokmak yerine tek seferde paralel üretmek.
Pratik sonucu şu: bir LLM çağrısında yanıt süresi büyük ölçüde ne kadar yazdığına bağlıdır, Jev’de ise neredeyse tamamen ne kadar okuduğuna. Bu yüzden soru sayısını üçten on beşe çıkarmak faturayı da süreyi de kayda değer biçimde değiştirmiyor.
Jev’in lansman tartışması Hacker News’te 1.900 puan ve 499 yoruma ulaştı. Almeida gün boyu soruları CompleteSkeptic hesabından yanıtladı, en açıklayıcı üçü şunlar:
“Çıktı tipi metin olsaydı bu da bir LLM olmaz mıydı, çıktı da LLM gibi ücretlenmez miydi?” sorusuna verdiği cevap, ücretsiz çıktının teknik sebebini veriyor: “strings (and all sequential data structures) are not allowed at all - this is how we make sure all outputs can be computed in parallel (thus no output token cost)” (yorum ). Yani dizgiler yasak olduğu için her çıktı paralel hesaplanabiliyor, çıktı token maliyeti de böylece ortadan kalkıyor.
“Bu genel bir model mi, yoksa kendi verinizle eğitmek gerekiyor mu?” sorusuna cevabı üç madde: “1. yes a general model, 2. no training at all, 3. but it is focused on ‘System 1’ tasks” (yorum ). İnce ayar yok, kendi verinizle eğitim yok; model sıfır atışlık çalışıyor ama alanı insan muhakemesine yakın işlerle sınırlı, matematik muhakemesi değil.
Kıyaslamalara duyulan şüpheye karşı da somut bir adres verdi: değerlendirmelerde referans olarak Astra ve Fable kullanıldığını, evals.typesafe.ai adresinde Jev ile opus/sol karşılaştırmalarının örnek izlerinin (trace) yayımlandığını söylüyor (yorum ).
Tartışmanın tamamı: Introducing System One Models and Jev .
Üç Soru Tipi: Choice, Score, Noul
Jev’in API’si üç primitife dayanıyor ve üçü de aynı istekte karışık olarak sorulabiliyor.
| Soru tipi | Ne sorar | Ne döner |
|---|---|---|
| Choice | Bu seçeneklerden hangisi? | choice, probabilities, confidence |
| Score | Hangi seviyede? | score, legend, probabilities, confidence |
| Noul | Bu ifade doğru mu? | noul (0 ile 1 arası) |
Choice tanımladığınız seçenekler arasından birini seçer ve her seçeneğin olasılığını verir. Score sıralı seviyelerden oluşan bir rubriğe göre puanlar, üstelik puan iki seviyenin arasına da düşebilir. Noul ise evet/hayır sorusudur ve cevabın “evet” olma olasılığını döndürür. 1’e yakın güçlü evet, 0’a yakın güçlü hayır, 0,5 civarı “bilmiyorum” demek. Noul’da ayrı bir güven skoru yok, olasılığın kendisi zaten o bilgiyi taşıyor.
Kritik ayrıntı: sorular paralel ve izole değerlendiriliyor. Soru eklemek yanıt süresini neredeyse hiç değiştirmiyor ve sorular birbirini kirletmiyor. LLM’lerde uzun promptlarda görülen bağlam çürümesi (context rot) burada yapısal olarak yok.
Nasıl Kullanılır?
Tek uç nokta var:
POST https://api.typesafe.ai/v1/systemone
Authorization: Bearer <API_KEY>
Content-Type: application/json
Bir destek talebini aynı anda üç boyutta değerlendiren gerçek bir istek şöyle görünüyor:
{
  "state": "Hi, I've been trying to connect my Stripe account for 3 days and it keeps failing. I'm losing sales. Please help ASAP.",
  "model": "jev-latest",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "Which team should handle this",
      "criteria": {
        "billing": "Payment or subscription issues",
        "technical": "Bugs or integration problems",
        "sales": "Pricing or account questions"
      }
    },
    "frustration": {
      "type": "score",
      "instructions": "How frustrated the customer appears",
      "criteria": [
        "Calm, just stating facts",
        "Frustrated but civil",
        "Very angry, strong language"
      ]
    },
    "is_urgent": {
      "type": "noul",
      "instructions": "The message conveys urgency or time-sensitivity"
    }
  }
}
Dönen cevapta parse edilecek hiçbir şey yok:
{
  "model": "jev-latest",
  "answers": {
    "department": {
      "type": "choice",
      "choice": "billing",
      "probabilities": { "billing": 0.84, "technical": 0.159, "sales": 0.001 },
      "confidence": 0.596
    },
    "frustration": {
      "type": "score",
      "score": 1.035,
      "legend": { "0": "Calm, just stating facts", "1": "Frustrated but civil", "2": "Very angry, strong language" },
      "confidence": 0.842
    },
    "is_urgent": { "type": "noul", "noul": 0.999 }
  },
  "usage": { "input_tokens": 312, "output_tokens": 48 }
}
Python tarafında resmi SDK var (Python 3.10 ve üzeri):
pip install typesafe-sdk
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()

response = client.system_one(
    state=ticket,
    questions={
        "department": Choice(
            instructions="Which team should handle this",
            criteria={
                "billing": "Payment or subscription issues",
                "technical": "Bugs or integration problems",
                "sales": "Pricing or account questions",
            },
        ),
        "is_urgent": Noul(instructions="The message conveys urgency"),
    },
)

print(response.answers["department"].choice)  # "billing"
print(response.answers["is_urgent"].noul)     # 0.999
JavaScript SDK’sı da mevcut. Denemek için kod yazmak istemiyorsanız console.typesafe.ai/playground üzerindeki oyun alanına herhangi bir metni yapıştırıp soru ekleyebilirsiniz. API anahtarı aynı konsoldan alınıyor. Hata kodları tanıdık: 401 geçersiz anahtar, 422 doğrulama hatası, 429 hız limiti, 529 servis aşırı yüklü.
Güven Skorunu Koda Bağlamak
Jev’in asıl farkı burada ortaya çıkıyor. confidence değeri, olasılık dağılımının ne kadar tepe yaptığını tek sayıya indiriyor. Dağılım bir seçeneğe toplanmışsa güven yüksek, yayılmışsa düşük.
TypeSafe’in önerdiği kalıp üç bantlı: yüksek güvende otomatik hareket et, orta güvende onay iste, düşük güvende insana yönlendir. Eşik, yapılan işin riskine göre değişmeli:
action = response.answers["action"]

if action.confidence < 0.5:
    route_to_human(user_message)          # model gerçekten emin değil
elif action.choice == "check_balance":
    show_balance(account_id)              # düşük riskli, geri alınabilir
elif action.choice == "approve_transfer":
    if action.confidence > 0.9:
        confirm_then_execute(account_id)  # yüksek risk, yüksek güven
    else:
        ask_user_to_confirm(account_id)
Aynı sistemde para transferi onayı ile bakiye gösterimi aynı eşiği paylaşmak zorunda değil. Risk toleransını prompt değil, kodunuz belirliyor.
Hız ve Maliyet: Gerçek Sayılar
| Kalem | Jev | Frontier LLM'ler |
|---|---|---|
| Girdi fiyatı | $0,042 / 1M token | $0,20 - $10 / 1M token |
| Çıktı fiyatı | Ücretsiz | Girdinin ~5 katı |
| Uçtan uca süre | 70 - 500 ms | 3 - 329 saniye |
| Örnekleme | Paralel, tek geçiş | Ardışık, token token |
| Tip hatası | Yok (şema garantili) | Modele göre %0,3 - %45 |
| Çıktı | Tipli değer + olasılık | Metin |
Fiyatın milyon token değil milyar token üzerinden ilan edilmesi başlı başına bir mesaj: girdi tarafı milyarda 42 dolar. Çıktı kararları ise ücretsiz, TypeSafe’in deyimiyle ölçmeye değmeyecek kadar ucuz.
Ana sayfadaki 193,6 kat hızlı, 444,6 kat ucuz iddiası dört iş akışının ortalamasından geliyor ve şirketin kendi ölçümü. Bağımsız değil, ama TypeSafe iddianın kaynağını ve yöntemini açık açık yayımlıyor.
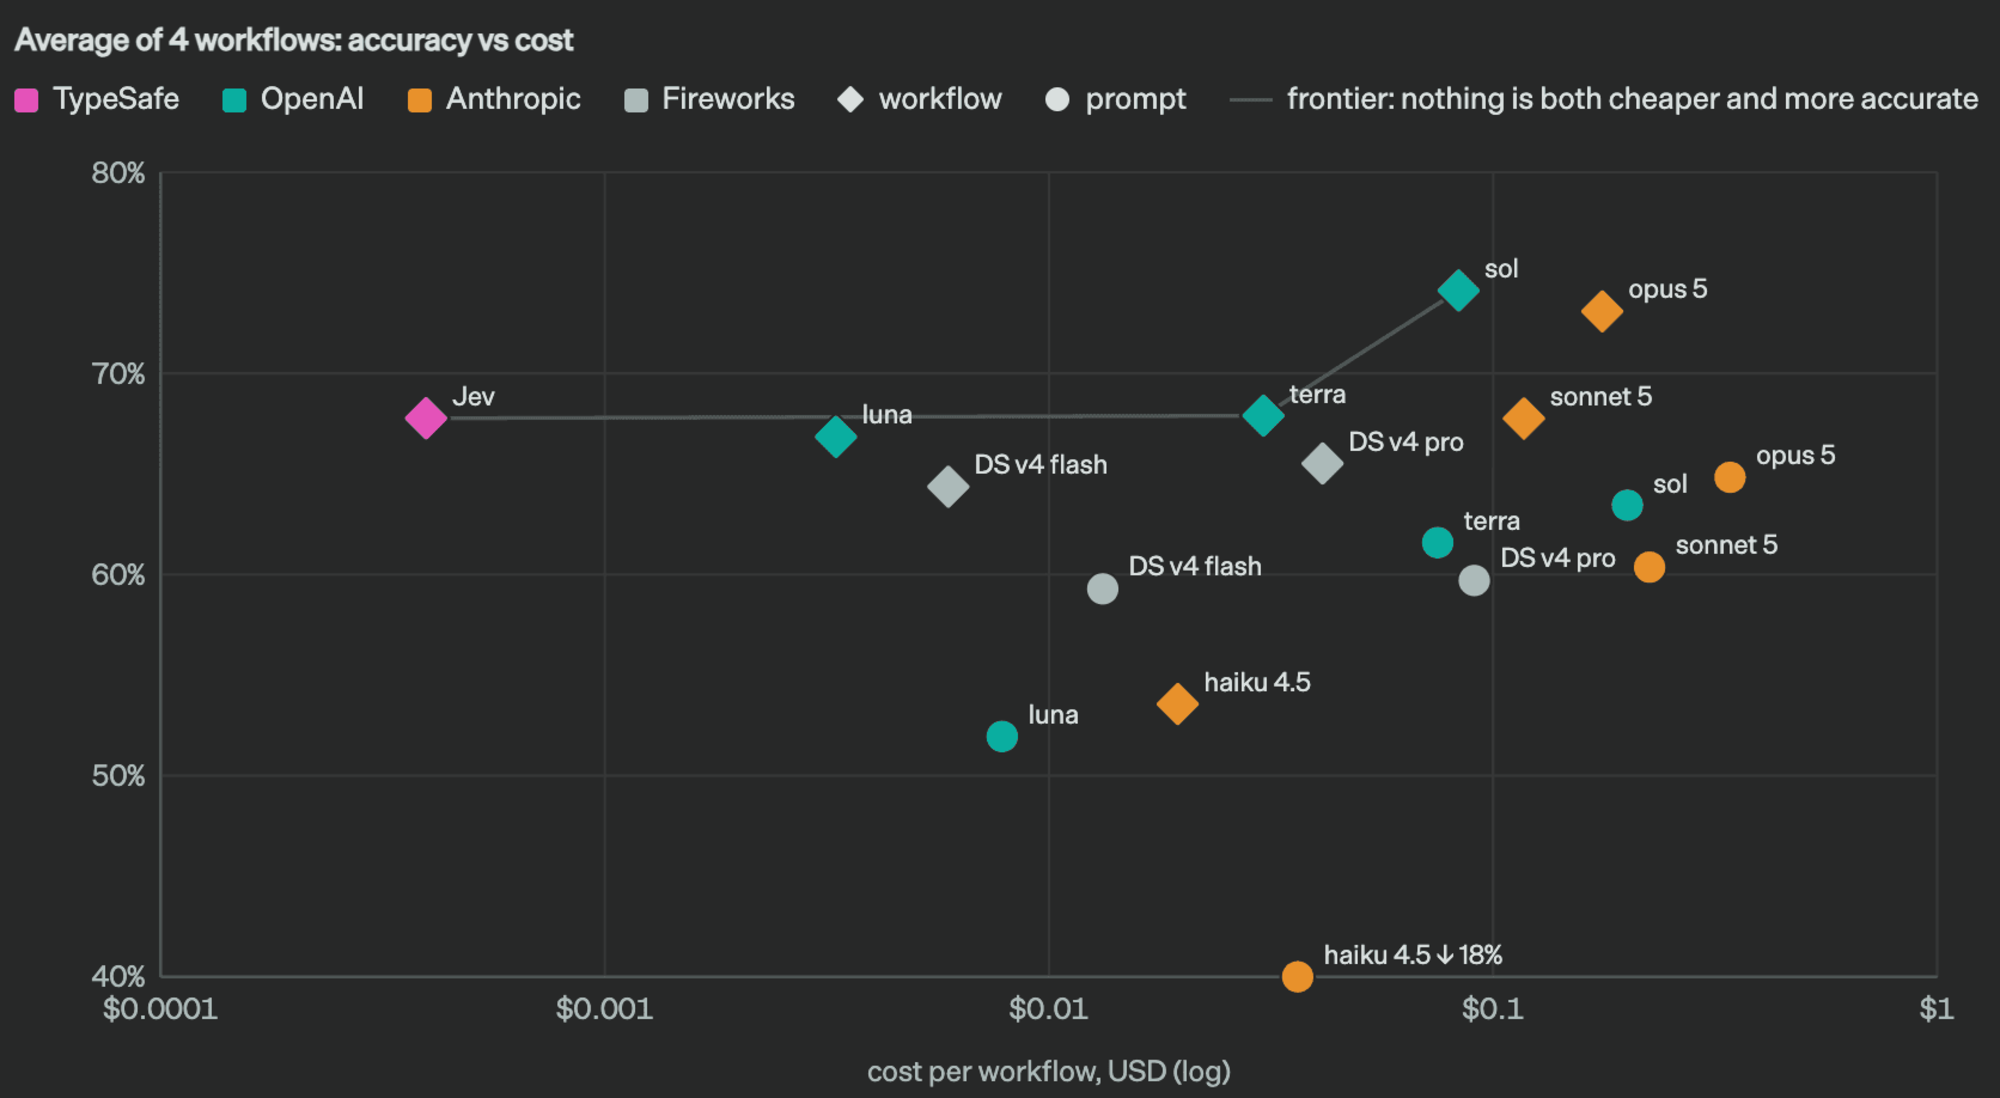
Grafiğin okunması gereken yeri yatay eksen: logaritmik. Jev, en yakın rakibinden yaklaşık iki büyüklük mertebesi solda duruyor. Doğruluk tarafında opus 5 ve sol birkaç puan önde, ama aradaki maliyet farkı yüzlerce kat.
TypeSafe’in demo videosunda tek bir çağrının hesabı şöyle: Jev 0,114 saniyede 0,000081 dolar, GPT-5.6 Terra 8,566 saniyede 0,013880 dolar. Kendi hacminizde ne anlama geldiğini LLM maliyet hesaplayıcısıyla karşılaştırabilirsiniz, Jev’i modeller listesine ekledim.
Tip Hatası Meselesi
Jev’in “halüsinasyon göremez” iddiası biraz kestirme bir ifade. Doğrusu şu: olası çıktıları siz önceden tanımladığınız için model şemanın dışına çıkamaz. Yanlış cevap verebilir, ama geçersiz cevap veremez.
Fark önemli. Bir sohbet uygulamasında bozuk bir araç çağrısı can sıkıcıdır, tekrar denersiniz. Aynı hata gecikme garantisi olan bir sistemin ya da bağımlılık zincirinin beş kat altındaki bir serviste çıktığında sorun büyür. TypeSafe’in yayımladığı ölçümlerde yapılandırılmış çıktı hata oranı haiku 4.5’te %45,5’e, sonnet 5’te %13,2’ye çıkıyor; opus 5 ve fable 5.1 gibi modellerde %5-8 bandında. Jev’in payı ise tanımı gereği sıfır.
Gerçek Bir İş Akışı Neye Benziyor?
TypeSafe’in yayımladığı dört iş akışından en basiti bir güvenlik uyarısı triyajı. Tek bir uyarı geliyor, kod üç okuma yapıyor, sonuçları birleştirip kapat/kuyruğa al/harekete geç kararını veriyor, harekete geçilirse on bir okuma daha yapılıyor ve en sonunda uygulanacak müdahale seçiliyor.
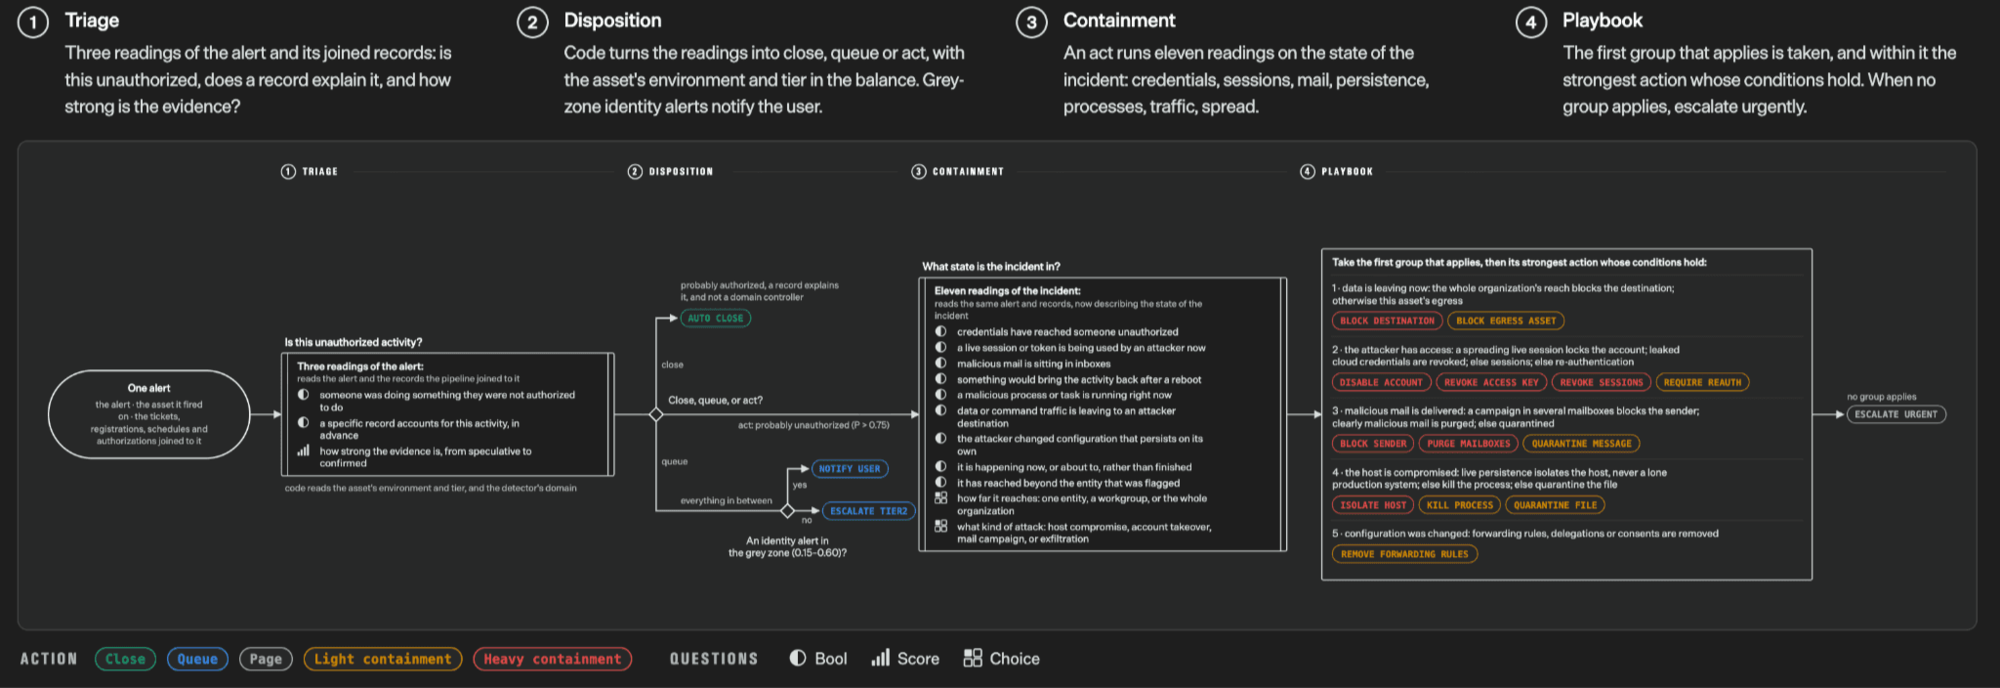
Buradaki tasarım fikri, dokümantasyonun tekrar tekrar altını çizdiği şey: her soru tek bir refleks kararı olmalı. “Bu girişim fikrini puanla” diye sormak yerine pazar büyüklüğünü, teknik uygulanabilirliği ve farklılaşmayı ayrı ayrı sorun, sonra kendi formülünüzle birleştirin. Öncelikler değiştiğinde promptu baştan yazmıyorsunuz, koddaki bir katsayıyı değiştiriyorsunuz.
Şirketin demoları da aynı mantığı gösteriyor. Jev, yapılandırılmış oyun durumu üzerinden Doom oynuyor (görüntü değil, veri yapısı okuyarak) ve saniyede 10 sorguyla saatlik maliyet yaklaşık 7 dolar oluyor. İkinci demo Wikiracing: her adımda yüzlerce bağlantı arasından seçim. Jev’in seçenek sayısı üst sınırı 255, üstüne çıkıldığında önce puanlayıp sonra seçen iki aşamalı bir sistem devreye giriyor.
Nerede İşe Yaramaz?
Jev bir LLM değil ve LLM’in yerine geçmiyor. Metin üretmiyor, kod yazmıyor, sohbet etmiyor, özetlemiyor. Uzun muhakeme gerektiren, çok faktörü birlikte tartan sorular da doğru kullanım değil; dokümantasyon bu tip soruları parçalara ayırmanızı söylüyor.
Kurucunun kendisi de takasın altını çiziyor:
Diogo Almeida: Jev metin üretemiyor, takas bu (15 Eylül 2026)
Kazanç bedava değil, Jev metin üretemiyor. Eklediği tarihsel benzetme de yerinde: ardışık hesabı paralel hesapla değiştirmek, Transformer mimarisinin RNN’leri geride bırakma biçimiydi. Jev aynı hamleyi çıktı tarafında yapıyor.
Dikkat edilecek diğer noktalar:
- Erken erişim. Model 16 Eylül’de erken erişime açıldı, giriş bekleme listesinden veriliyor. Lansmandan sonra yoğun talep yüzünden API kesintileri yaşandı.
- Kıyaslamalar şirketin kendi ölçümü. TypeSafe iş akışlarını kendi model yetenekleri ekibinin hazırladığını, ölçümlerin Batı Yakası’ndaki kendi dizüstü bilgisayarlarından koştuğunu ve referans cevapların GPT-6 Astra ile Fable 5.1 ortalaması olduğunu açıkça yazıyor. Örnek izleri
evals.typesafe.aiadresinde yayımlamış olması en azından tek tek karşılaştırma yapmayı mümkün kılıyor. - Fiyat sürdürülebilirliği kanıtlanmış değil. Şirket sübvansiyonlu olmadığını kanıtlayamayacağını, fiyatların artmasını değil düşmesini beklediğini söylüyor.
- Güven eşiğini siz belirliyorsunuz. Model size bir olasılık verir, o olasılıkla ne yapacağınız tamamen sizin tasarımınız.
- Jevons paradoksu. İsim bir şaka değil, beklenti: birim maliyet düştükçe toplam token tüketiminin azalmayıp artması bekleniyor.
Bağımsız ilk denemeler de umut verici ama tek taraflı değil. TechCrunch’ın aktardığına göre Vercel, güvenlik sınıflandırmasında 5-18 kat hız kazancı ölçmüş. E-posta sınıflandırması yapan Bryo AI ise Gemini’a göre 10-20 kat daha ucuz bulmuş, fakat doğrulukta Gemini’ı bir tık önde görmüş. Onların tercih sebebi hız değil, gerçek bir olasılık değeri alabilmek olmuş.
Ekosistem Şimdiden Hareketli
İlk 72 saatte LangChain kendi entegrasyonunu yayımladı (langchain_typesafe içindeki TypeSafeClassifier), model OpenRouter ve Cloudflare kataloglarına girdi, liteLLM passthrough ekledi. Hacker News tarafında Jev’i yerel bir LLM üzerinde taklit eden mini-jev ve kendi GPU’nuzda çalışan açık alternatif denemeleri belirdi.
TypeSafe kodlama ajanları için bir beceri (skill) paketi de yayımladı. Claude Code’da kurulumu iki komut:
claude plugin marketplace add typesafe-ai/skills
claude plugin install typesafe@typesafe-ai
Mevcut Bir LLM Çağrısını Jev’e Taşımak
Elinizde zaten çalışan bir sınıflandırma çağrısı varsa, geçiş promptu çevirmekle başlamıyor. Sıralama şöyle işliyor:
- Promptu sorulara ayırın. Promptunuzdaki her “şunu da değerlendir” cümlesi ayrı bir soru olmalı. Tek bir dev talimat yerine üç beş atomik soru, hem daha tutarlı hem daha ucuz.
- Her soruya tip seçin. Kapalı bir liste varsa Choice, sıralı seviyeler varsa Score, evet/hayır ise Noul. Serbest metin isteyen bir alan kaldıysa o alan Jev’e taşınmaz, LLM’de kalır.
- Seçenek açıklamalarını yazın.
criteriaalanı boş geçilebilir ama seçeneğin ne anlama geldiğini bir cümleyle anlatmak doğruluğu belirgin biçimde artırıyor. - Eşikleri kodda tanımlayın. Eskiden promptta “emin değilsen bilmiyorum de” yazıyordunuz; artık bunun yerine güven skorunu eşikliyorsunuz.
- Paralel koşturup karşılaştırın. İlk hafta iki sistemi yan yana çalıştırıp uyuşmazlıkları biriktirin.
Hibrit kullanım da mantıklı: isteği Jev sınıflandırıp yönlendirsin, metin gereken adımda LLM devreye girsin. TypeSafe’in “intent routing” kalıbı bunu tarif ediyor.
Kimin İçin Mantıklı?
Jev’i bugün denemeye değer kılan senaryolar oldukça net: gelen talepleri sınıflandırıp yönlendirmek, dolandırıcılık riski puanlamak, LLM çıktılarını denetlemek ve jailbreak tespit etmek, büyük veri kümeleri üzerinde map-reduce tarzı etiketleme yapmak, oyun ve robot gibi 100 milisaniyenin önemli olduğu gerçek zamanlı döngüler.
Bir LLM’e “şu metni şu kategorilerden birine ata ve sadece JSON dön” diye yalvardığınız her yerde Jev’in yerine bakması muhtemel. Ama asistan, editör, kod üreteci ya da içerik motoru arıyorsanız yanlış adres: o iş hâlâ GPT-5.6 ve Claude Opus 5 gibi modellerin işi.
En doğru okuma belki de şu: bu iki model sınıfı birbirinin rakibi değil. LLM’ler insanla konuşur, System One modelleri yazılımla. Aradaki tercüme katmanını ortadan kaldırmak, otomasyonda uzun süredir eksik olan parçaydı.